我们熟知LLM里有3种典型的KL估计器,也经常听到说这个估计器是无偏的,那个估计器是有偏的;又或者听到说这个估计器虽然是无偏的但是梯度估计是有偏的。 不熟悉的人可能会问,什么叫无偏?什么叫有偏?梯度无偏有偏又是怎么回事?
首先,先介绍一下怎么判断”无偏”还是”有偏”? 判断标准只有一个:看数学期望(平均值)是否等于目标值。
- 无偏(Unbiased):如果你重复无数次实验,计算所有估计值的平均值,这个平均值 恰好等于 你要估计的那个真实值。
- 有偏(Biased):这个平均值 不等于 真实值,存在系统性偏差。
对于KL无偏估计器,意味着$E[\hat{KL}]=KL$;对于梯度无偏估计器,意味着$E[\hat{g}]=\nabla_\theta L$。
这里其实没有什么特别神秘的地方。区别只在于:你到底在估计什么。
而这句话正是整篇文章的题眼。因为在 RL 训练里,我们其实同时在估计两个不同的东西:
- KL 的值——它进 log、进监控面板、进 early stop 的判据,我们希望它准;
- KL 的梯度——它才是真正改变模型参数的东西,我们希望它指向正确的方向。
这两件事没有任何逻辑蕴含关系。一个估计器可以值无偏而梯度有偏,也可以值有偏而梯度无偏。
下面把这件事拆开讲。
一、三个估计器:k1 / k2 / k3
先把符号定好。我们要估计的是当前 policy $\pi_\theta$ 相对参考模型 $\pi_{\text{ref}}$ 的 KL:
$$D_{\text{KL}}(\pi_\theta \| \pi_{\text{ref}}) = \mathbb{E}_{y\sim\pi_\theta}\left[\log\frac{\pi_\theta(y|x)}{\pi_{\text{ref}}(y|x)}\right]$$
这里顺手把方向的名字定下来,后面会反复用到:$D_{\text{KL}}(\pi_\theta\|\pi_{\text{ref}})$ 叫反向 KL(reverse KL)——它是 mode-seeking 的,$\theta$ 只需要在自己有输出的地方跟 ref 对齐,ref 有但 $\theta$ 没生成过的地方完全不管。反过来 $D_{\text{KL}}(\pi_{\text{ref}}\|\pi_\theta) = \mathbb{E}_{y\sim\pi_{\text{ref}}}[\log(\pi_{\text{ref}}/\pi_\theta)]$ 叫正向 KL(forward KL),是 mass-covering 的——它要求 $\theta$ 在 ref 有质量的地方都不能塌成 0。
RLHF 用反向 KL 不是随手选的:一是它只需要对 $\pi_\theta$ 采样(不用枚举 ref 的支撑集),工程上天然契合”用当前策略生成、算 log-ratio”这套流程;二是它是 zero-forcing 的——只要 $\theta$ 敢生成一个 ref 认为极不可能的东西,KL 就会爆炸,这正好是”别让模型说出 ref 绝对不会说的话”这个防 reward hacking 的诉求。本文第一节到第五节说的”KL”,如果不特别说明,都是指反向 KL $D_{\text{KL}}(\pi_\theta\|\pi_{\text{ref}})$。
注意这是一个期望,而我们只有采样。为了记号方便,定义似然比
$$s(y) = \frac{\pi_{\text{ref}}(y|x)}{\pi_\theta(y|x)}$$
(注意方向:分子是 ref。这个方向的好处是 $\mathbb{E}_{y\sim\pi_\theta}[s(y)]=1$,后面反复要用。)
k1:最朴素的那个
$$k_1(y) = \log\frac{\pi_\theta(y|x)}{\pi_{\text{ref}}(y|x)} = -\log s(y)$$
直接把期望里的东西拿出来当估计。它显然是无偏的——这几乎是同义反复,因为 KL 的定义就是它的期望。
但 k1 有个很扎眼的毛病:KL 恒非负,而 k1 有一半的取值空间是负数。你采一条 response,很可能算出个负的”KL”。这不是 bug,是单样本估计的本性,但它意味着方差极大。
这个方差有多大?我做了个数值实验(50 类离散分布,附录有脚本):
| 真实 KL | k1 的标准差 | 标准差 / 信号 |
|---|---|---|
| 0.1921 | 0.6435 | 3.3× |
| 0.0197 | 0.2001 | 10× |
| 0.0011 | 0.0476 | 42× |
| 0.00018 | 0.0190 | 105× |
结论很清楚:$\pi_\theta$ 越接近 $\pi_{\text{ref}}$,k1 的信噪比越差,而”接近 ref”恰恰是 RL 训练绝大部分时间所处的状态。所以如果用 k1 单样本值去画监控曲线——画出来的可能基本是噪声。
(顺带一提:这个”信噪比随 KL 变小而变差”的规律,本身就说明了 k2/k3 这类方差缩减手段的必要性不是可有可无的工程优化,而是刚需。)
k2:把它掰成非负的
$$k_2(y) = \frac{1}{2}\left(\log s(y)\right)^2$$
平方一下就非负了。代价是它对 KL 有偏。
但这个偏有多大?把 k1 和 k2 在 $s=1$ 附近做二阶 Taylor 展开:
$$k_1 \approx (1-s) + \tfrac{1}{2}(s-1)^2, \qquad k_2 \approx \tfrac{1}{2}(s-1)^2$$
两者只差一个线性项 $(1-s)$,而这一项的期望恰好是 0(因为 $\mathbb{E}[s]=1$)。所以 k2 的偏差是三阶小量——当 $\pi_\theta \approx \pi_{\text{ref}}$ 时可以忽略。数值上:
| 真实 KL | E[k2] | 相对偏差 |
|---|---|---|
| 0.1921 | 0.2255 | +17% |
| 0.0197 | 0.0202 | +2.4% |
| 0.0011 | 0.00113 | <0.5% |
所以 k2 的定位很清楚:近距离下的低方差近似。KL 大到 0.2 那个量级时,它会系统性高估 17%,这时候你不该再信它的绝对值。
k3:控制变量法
k3 的思路更漂亮一点。既然 k1 无偏但方差大,那就给它加一个期望为 0 的项来降方差——这是统计里标准的控制变量(control variate)技巧:
$$k_3(y) = k_1(y) + \lambda\,(s(y)-1) = -\log s(y) + \lambda\,(s(y)-1)$$
$\mathbb{E}[s-1]=0$,所以无论 $\lambda$ 取多少,k3 都是 KL 的无偏估计。而只要 $(s-1)$ 和 $k_1$ 负相关,就能降方差。
取 $\lambda=1$,理由不是方差最优,而是保证非负:由 $\log x \le x-1$ 可得 $k_3 = s - 1 - \log s \ge 0$。
这里有个细节值得提:$\lambda=1$ 到底离方差最优有多远?理论上最优 $\lambda^\star = -\mathrm{Cov}(k_1, s-1)/\mathrm{Var}(s-1)$。我数值算了一下:
| 真实 KL | $\lambda^\star$ | sd(k3, λ=1) | sd(k3, λ*) |
|---|---|---|---|
| 0.1921 | 0.846 | 0.3270 | 0.3105 |
| 0.0197 | 1.015 | 0.01846 | 0.01823 |
| 0.00018 | 0.995 | 0.000300 | 0.000280 |
当两个分布接近时 $\lambda^\star \to 1$,也就是说 Schulman 为了非负性选的 $\lambda=1$ 恰好几乎就是方差最优的。这不是巧合——在 $s\to1$ 的极限下这两个诉求会合流。这大概是 k3 之所以好用的深层原因:它同时满足了非负、无偏、近似方差最优三件事。
小结这一节
| 对 KL 值 | 非负 | 方差 | |
|---|---|---|---|
| k1 | 无偏 | 否 | 很大 |
| k2 | 有偏(三阶小) | 是 | 小 |
| k3 | 无偏 | 是(λ=1) | 小,近似最优 |
看到这张表,任何人的第一反应都是:k3 全面占优,用 k3 就完了。事实上业界也是这么做的——很多框架的 GRPO 干脆只实现了 k3。
但这张表只回答了”值”的问题。一旦进入梯度,结论会整个翻过来。
二、唯一需要记住的那个公式:梯度有两项
这是整篇文章的技术核心,理解了它,后面所有结论都是推论。
把 KL 估计项统一记作 $f_\theta(y)$(k1/k2/k3 都可以代进去)。注意 $f$ 的下标 $\theta$ 和采样分布的 $\theta$ 是同一个 $\theta$——这是全部麻烦的来源。
$$\hat D_{\text{KL}} = \mathbb{E}_{y\sim\pi_\theta}[f_\theta(y)] = \sum_y \pi_\theta(y|x)\, f_\theta(y)$$
求和号里有两处依赖 $\theta$。所以求导要用乘积法则:
$$\nabla_\theta \hat D_{\text{KL}} = \mathbb{E}_{y\sim\pi_\theta}\Big[\underbrace{f_\theta(y)\,\nabla_\theta \log \pi_\theta(y|x)}_{\text{得分函数导数 (score function)}} + \underbrace{\nabla_\theta f_\theta(y)}_{\text{路径导数 (pathwise)}}\Big]$$
(第二个等号用了对数技巧 $\nabla_\theta \pi_\theta = \pi_\theta \nabla_\theta\log\pi_\theta$。)
这两项的物理含义完全不同,值得掰开说:
- 得分函数项:$\theta$ 变了 → 采到的 $y$ 的分布变了 → KL 变了。这是”我少生成一点 KL 高的序列”。
- 路径导数项:$\theta$ 变了 → 同一个 $y$ 上 KL 的数值变了 → KL 变了。这是”对于我已经生成的这条序列,我把它的 log prob 往 ref 拉”。
真正的 KL 梯度必须两项都有。 这就是”正确形式”。
而现实是——没有任何主流实现两项都算。所有实现都只算其中一项。哪一项被丢掉,取决于你在哪里 stop-gradient。
三、两种放法,其实是两种 stop-gradient
加了 KL 正则的目标函数,正确的写法是(用红色标记需要回传梯度的 $\theta$):
$$J(\textcolor{red}{\theta}) = \mathbb{E}_{y\sim\pi_{\textcolor{red}{\theta}}}[r(x,y)] - \beta\,\mathbb{E}_{y\sim\pi_{\textcolor{red}{\theta}}}\left[\log\frac{\pi_{\textcolor{red}{\theta}}(y|x)}{\pi_{\text{ref}}(y|x)}\right]$$
注意 KL 项里采样分布的 $\theta$ 和 log 里的 $\theta$ 都要回传梯度。
但工程上,实际跑的永远是下面两个变体之一:
KL in Reward(IR,OpenAI/InstructGPT 路线)
$$J_{\text{IR}}(\textcolor{red}{\theta}) = \mathbb{E}_{y\sim\pi_{\textcolor{red}{\theta}}}[r] - \beta\,\mathbb{E}_{y\sim\pi_{\textcolor{red}{\theta}}}\left[\log\frac{\pi_{\theta}(y|x)}{\pi_{\text{ref}}(y|x)}\right]$$
log 项里的 $\theta$ 没有标红——它被 stop-grad 了。实现上就是把 KL 当成一个数值塞进 reward:
$$r_t' = r_t - \beta\log\frac{\pi_\theta(y_t|s_t)}{\pi_{\text{ref}}(y_t|s_t)}$$
trl 的 PPO 里这段整个包在 torch.no_grad() 里,非常直白:
with torch.no_grad():
    logr = ref_logprobs - logprobs
    kl = -logr if args.kl_estimator == "k1" else (logr.exp() - 1) - logr   # else 分支是 k3
    non_score_reward = -args.kl_coef * kl
    rewards = non_score_reward.clone()
    rewards[actual_start, actual_end] += scores
IR = 丢掉路径导数,只保留得分函数导数。
KL in Loss(IL,DeepSeek/GRPO 路线)
$$J_{\text{IL}}(\textcolor{red}{\theta}) = \mathbb{E}_{y\sim\pi_{\textcolor{red}{\theta}}}[r] - \beta\,\mathbb{E}_{y\sim\pi_{\theta}}\left[\log\frac{\pi_{\textcolor{red}{\theta}}(y|x)}{\pi_{\text{ref}}(y|x)}\right]$$
这次是采样分布的 $\theta$ 被 stop-grad 了(实现上体现为:KL 项直接作为一个 loss 加进去,不经过 advantage / policy gradient 通道)。
IL = 丢掉得分函数导数,只保留路径导数。
所以,回到题目里的那个问题——实现细节(是否 stop-gradient 某一项)会不会改变有偏性结论?
答案是:它就是有偏性结论本身。 IR 和 IL 的全部区别就是 stop-grad 打在哪儿;而 stop-grad 打在哪儿,决定了两项梯度里哪一项被丢。
四、六宫格:3 个估计器 × 2 种放法
现在把 k1/k2/k3 分别代进 IR 和 IL,逐格算。我把结论先摆出来,再讲推导:
| KL in Reward(丢路径导数) | KL in Loss(丢得分函数导数) | |
|---|---|---|
| k1 | ✅ 梯度无偏(精确等于真梯度) | ❌ 梯度恒等于 0,纯噪声 |
| k2 | ❌ 正则塌陷 | ✅ 梯度无偏(精确等于真梯度) |
| k3 | ❌ 正则塌陷 | ⚠️ 精确的正向 KL 梯度 |
这张表的反直觉之处在于:k1 和 k2 的角色是完全对调的。值上无偏的 k1,只在 reward 里对;值上有偏的 k2,只在 loss 里对。而值上”全面占优”的 k3,两边都不是我们想要的反向 KL 梯度。verl 甚至专门提供了 k3+ 版本,前向算 k3 的值(非负、低方差,报出去当监控数值),反向传播时却换成 k2 的梯度——本质上就是拿”这一格的问题”当作一个已知坑主动绕开:数值走 k3,梯度走 k2-IL(等于 4.3 那个恒等式),两头都占。
但要强调一点,也是我后来才想明白的:表里的 ❌ 和 ⚠️ 严重程度差了两个数量级,而且方向相反。
- ❌ 那几格是失效:k1-IL 梯度恒为 0,k2/k3-IR 的梯度在 $\pi_\theta\to\pi_{\text{ref}}$ 时会塌陷到真梯度的 1% 以下(4.4 会算给你看)。你以为加了正则,其实没加。
- ⚠️ 那格是换了个散度:k3-IL 不是”算歪了的反向 KL”,它精确地是正向 KL 的梯度。而正向 KL 本身就是个合法且好用的正则化目标(只是 mass-covering,跟我们设计初心的 mode-seeking 方向不同)。
这个区分很重要,因为它解释了一个否则很难理解的现象:既然 k3 两边都不是真梯度,为什么业界还是普遍在用它? 答案是大家用的是 ⚠️ 那格(GRPO 系走的都是 IL),而那一格实践上站得住。真正的坑是 ❌ 那几格。
4.1 为什么 k1-in-Reward 是精确无偏的
IR 丢掉了路径导数,看起来一定错。但对 k1:
$$\nabla_\theta f_\theta(y) = \nabla_\theta \log\frac{\pi_\theta(y|x)}{\pi_{\text{ref}}(y|x)} = \nabla_\theta\log\pi_\theta(y|x)$$
($\pi_{\text{ref}}$ 与 $\theta$ 无关,直接消失。)而这一项的期望恒为 0:
$$\mathbb{E}_{y\sim\pi_\theta}[\nabla_\theta f_\theta(y)]=\mathbb{E}_{y\sim\pi_\theta}[\nabla_\theta\log\pi_\theta(y|x)] = \sum_y \nabla_\theta \pi_\theta(y|x) = \nabla_\theta \sum_y \pi_\theta(y|x) = \nabla_\theta 1 = 0$$
丢掉的东西期望为 0,所以什么都没丢。 k1-IR 的梯度和完整正确梯度完全一致,不是近似,是恒等。
这带来一个很有用的推论:对 k1 而言,log 项里的 $\theta$ 要不要 stop-grad,梯度形式一模一样:
$$\nabla_\theta \mathbb{E}_{y\sim\pi_{\textcolor{red}{\theta}}}\left[\log\frac{\pi_{\theta}}{\pi_{\text{ref}}}\right] = \nabla_\theta \mathbb{E}_{y\sim\pi_{\textcolor{red}{\theta}}}\left[\log\frac{\pi_{\textcolor{red}{\theta}}}{\pi_{\text{ref}}}\right] = \mathbb{E}\left[\log\frac{\pi_\theta}{\pi_{\text{ref}}}\nabla_\theta\log\pi_{\textcolor{red}\theta}\right]$$
k1 对 stop-grad 免疫。 这个鲁棒性本身就是一个很强的工程优点——它意味着这条路径上少一个可以写错的地方。
4.2 为什么 k1-in-Loss 是纯噪声
同一个事实,换个位置,结论就反过来了。IL 保留的恰好就是那个期望为 0 的路径导数项:
$$\nabla_\theta \mathbb{E}_{y\sim\pi_\theta}\left[\log\frac{\pi_{\textcolor{red}\theta}}{\pi_{\text{ref}}}\right] = \mathbb{E}_{y\sim\pi_\theta}[\nabla_\theta\log\pi_{\textcolor{red}\theta}] = 0$$
k1-in-Loss 的梯度期望恒为 0。 它不是”有偏”——它是根本没有正则化作用。你以为你在约束模型不要偏离 ref,实际上你只是往梯度里注入了一坨均值为 0 的噪声。它唯一的效果是增大梯度方差。
这大概是六宫格里最危险的一格:它不报错,loss 曲线看起来也正常,但它什么都没做。
4.3 为什么 k2-in-Loss 反而是对的
k2 的路径导数:
$$\nabla_\theta f_\theta(y)=\nabla_\theta \tfrac{1}{2}(\log s)^2 = \log s \cdot \nabla_\theta \log s = -\log s \cdot \nabla_\theta\log\pi_{\textcolor{red}\theta} = \log\frac{\pi_\theta}{\pi_{\text{ref}}}\nabla_\theta\log\pi_{\textcolor{red}\theta}$$
对比 4.1 的结果——这和 k1-IR 的梯度一字不差。
$$\boxed{\text{k2-in-Loss} \equiv \text{k1-in-Reward}}$$
这个恒等式非常值得记住。它说明:k2 那个”多出来”的平方,作用不是改变 KL 的值,而是把 KL 的值当成系数塞进路径导数里,从而人工复现出得分函数项。k2 在值上的有偏,换来了梯度上的精确无偏。
也就是说,“k2 是有偏估计器”这句话,在梯度语境下是彻底的误导。
4.4 k3 两边都不是真梯度——但两边错得完全不一样
k3(λ=1)的路径导数:
$$\nabla_\theta\,\mathbb{E}[s - \log s - 1] = \mathbb{E}\left[\left(1 - \frac{\pi_{\text{ref}}}{\pi_\theta}\right)\nabla_\theta\log\pi_{\textcolor{red}\theta}\right] = \mathbb{E}\left[-(s-1)\,\nabla_\theta\log\pi_{\textcolor{red}\theta}\right]$$
对比 k2-IL(正确)的系数 $-\log s$,k3-IL 的系数是 $-(s-1)$。两者在 $s\to 1$ 时一致,但在远处会分道扬镳:
- $\pi_\theta \gg \pi_{\text{ref}}$($s\to 0$):正确系数 $-\log s \to +\infty$,强烈惩罚;k3 的系数只趋于 $1$,惩罚不足。
- $\pi_\theta \ll \pi_{\text{ref}}$($s\to\infty$):正确系数以 $\log$ 增长,k3 的系数线性增长,更激进。
不过,把这些系数差异说成”k3-IL 是个粗糙近似”其实没抓到点子上。上面那个期望有一个精确的身份。注意 $\mathbb{E}[\nabla_\theta\log\pi_\theta]=0$,所以
$$\mathbb{E}\left[-(s-1)\nabla_\theta\log\pi_\theta\right] = -\mathbb{E}\left[s\,\nabla_\theta\log\pi_\theta\right] = -\sum_y \pi_{\text{ref}}\,\nabla_\theta\log\pi_\theta = \nabla_\theta D_{\text{KL}}(\pi_{\text{ref}}\|\pi_\theta)$$
也就是:
$$\boxed{\nabla_\theta\big[\text{k3-in-Loss}\big] = \nabla_\theta D_{\text{KL}}(\pi_{\text{ref}}\|\pi_\theta)}$$
(数值验证残差 $\sim10^{-10}$,见附录 B。)
k3-in-Loss 不是”算歪了的反向 KL 梯度”,它是精确的正向 KL 梯度。 这是个完全不同性质的陈述——它不是在近似一个东西而近似歪了,它是在精确地优化另一个东西。
这也是 GRPO 原始论文(DeepSeekMath)里那个 k3 loss 项真正的问题所在:写下 $\beta\cdot k_3(y;\theta)$ 直接反传的人,本意显然是要用反向 KL 拴住模型(这是全文开头就讲清楚的设计初心),但代码算出来的却是正向 KL 的梯度——不是大小错了,是方向错了。第五节会看到,这个”方向错误”的根源和”能不能补救”,其实跟采样是不是 on-policy 密切相关,第六节会专门展开。
所以 k3-IL 至少在 on-policy、$\pi_\theta\approx\pi_{\text{ref}}$ 的区间里是个可用的选择,只是你应该知道自己在正则哪个散度。它跟 k1-IL(梯度恒为 0,什么都没做)完全不是一个错误等级。
真正的坑:k3-in-Reward
k3-IR 的梯度是 $\mathbb{E}[k_3 \nabla_\theta\log\pi_\theta]$,比正确梯度 $\mathbb{E}[k_1\nabla_\theta\log\pi_\theta]$ 多了一项 $\lambda\,\mathbb{E}[(s-1)\nabla_\theta\log\pi_\theta]$。而这一项我们刚刚才算过——它正是 $\nabla_\theta D_{\text{KL}}(\pi_{\text{ref}}\|\pi_\theta)$。所以(取 $\lambda=1$):
$$\boxed{\nabla_\theta \big[\text{k3-in-Reward}\big] = \underbrace{\nabla_\theta D_{\text{KL}}(\pi_\theta\|\pi_{\text{ref}})}_{\text{反向 KL 梯度,我们想要的}} - \underbrace{\nabla_\theta D_{\text{KL}}(\pi_{\text{ref}}\|\pi_\theta)}_{\text{正向 KL 梯度,混进来的}}}$$
(我数值验证过,误差 $\sim 10^{-10}$,见附录。)
这个式子有两个推论,第二个尤其重要:
推论 1:k3-IR 想给的是反向 KL 的梯度,但额外混入了一个符号相反的正向 KL 梯度项。 它不是”带噪声的正则化”,噪声是零均值的,这个混入项不是——它是一个系统性的、方向相反的干扰项。
推论 2(更要命的):在 $\pi_\theta\approx\pi_{\text{ref}}$ 时,这两项会一阶抵消。 因为在小扰动下正向和反向 KL 都近似等于 $\frac{1}{2}\Delta^\top F \Delta$($F$ 是 Fisher 信息矩阵),二者到二阶为止是相等的,梯度也就相互抵消了。
换个角度看更直观:k3-IR 的梯度系数是 $k_3 = s-1-\log s \approx \frac{1}{2}(s-1)^2$,是二阶小量;而正确系数 $k_1 = -\log s \approx (1-s)$ 是一阶小量。差了整整一阶。
数值上这个效应非常剧烈:
| $\Vert\pi_\theta - \pi_{\text{ref}}\Vert$ | 真梯度模长 | k3-IR 梯度模长 | 比例 |
|---|---|---|---|
| 大 | 1.76e-1 | 3.04e-2 | 17% |
| 中 | 1.01e-1 | 2.82e-2 | 28% |
| 小 | 1.52e-2 | 7.54e-4 | 5.0% |
| 很小 | 3.03e-2 | 2.25e-4 | 0.74% |
所以 k3-in-Reward 的问题不是”有点偏”,而是”在你最需要它工作的区间里,它几乎不产生任何正则化梯度”。
这解释了一个很多人踩过但没想明白的现象:明明加了 KL 惩罚、监控面板上 KL 数值也算得挺准(k3 值确实无偏!),但模型该漂还是漂。 因为值算对了,梯度是空的。
(k2-in-Reward 有完全相同的病理,原因一样:k2 的系数也是二阶小量。看数值表里 k2_IR 的模长和 k3_IR 几乎一样小。)
把 IR 和 IL 并排放:同一个 0.7%,相反的含义
k3 的两格现在都有了精确身份,放在一起看非常有意思:
| 精确身份 | $\pi_\theta\to\pi_{\text{ref}}$ 时 | |
|---|---|---|
| k3-IL | $\nabla D_{\text{KL}}(\pi_{\text{ref}}\Vert\pi_\theta)$(正向 KL 梯度) | 相对真梯度(反向 KL 梯度)误差 → 0.63%(几乎完美) |
| k3-IR | $\nabla D_{\text{KL}}(\pi_\theta\Vert\pi_{\text{ref}}) - \nabla D_{\text{KL}}(\pi_{\text{ref}}\Vert\pi_\theta)$(反向 − 正向) | 梯度模长 → 真梯度的 0.74%(几乎为零) |
两个都是 0.7% 量级的数字,含义却完全相反:IL 是”只差 0.6%”,IR 是”只剩 0.7%”。
根源就是那个减号。IL 保留的是单个正向 KL 梯度——一个一阶量,恰好在 $\pi_\theta\approx\pi_{\text{ref}}$ 处跟反向 KL 梯度几乎重合;IR 保留的是反向、正向两个 KL 梯度相减——一阶部分抵消掉,只剩二阶残渣。
同一个估计器,换个位置,从”几乎完美”变成”几乎为零”。 这大概是全文最能说明”有偏性是组合的属性、不是估计器的属性”的一个例子。
五、Token-level 的坑:那个所有人都漏掉的 Part 2
到这里为止的推导都是 sequence-level 的。但实现是 token-level 的,而这中间会掉东西。
把 k1 的正确梯度展开成 token 形式:
$$ \begin{aligned} \nabla_\theta \hat D_{\text{KL}} &= \mathbb{E}\left[\sum_{t=1}^T \nabla_\theta\log\pi_\theta(y_t|s_t)\sum_{n=t}^{T}\log\frac{\pi_\theta(y_n|s_n)}{\pi_{\text{ref}}(y_n|s_n)}\right] \\ &= \underbrace{\mathbb{E}\left[\sum_t \nabla_\theta\log\pi_\theta(y_t|s_t)\cdot\log\frac{\pi_\theta(y_t|s_t)}{\pi_{\text{ref}}(y_t|s_t)}\right]}_{\text{Part 1:当前 token 自己的 KL}} + \underbrace{\mathbb{E}\left[\sum_t \nabla_\theta\log\pi_\theta(y_t|s_t)\cdot\sum_{n=t+1}^{T}\log\frac{\pi_\theta(y_n|s_n)}{\pi_{\text{ref}}(y_n|s_n)}\right]}_{\text{Part 2:后续 token 的 KL}} \end{aligned} $$
(中间那步 $\sum_{n=1}^T \to \sum_{n=t}^T$ 用的是 policy gradient 的 reward-to-go 结论。)
而几乎所有框架的 token-level KL-in-Loss 实现,只算了 Part 1。
Part 2 的含义是:我现在选这个 token,会把后续生成引导到什么样的状态上去,那些状态的 KL 是高是低。 漏掉它,等于在优化时完全忽略了当前 token 对后续 KL 惩罚的级联影响——KL 正则从一个序列级的约束退化成了一个逐 token 的局部近似。
这一条的杀伤力在于:它把 4.3 那个漂亮的结论作废了。 k2-in-Loss 在 sequence-level 上是精确无偏的,但一旦按主流方式做 token-level 实现,Part 2 一丢,它在实现层面重新变回有偏。
所以六宫格要再补一列:
| IR | IL (sequence, 理论) | IL (token, 主流实现) | |
|---|---|---|---|
| k1 | ✅ 精确 | ❌ 恒为 0 | ❌ 恒为 0 |
| k2 | ❌ 有偏 | ✅ 精确 | ❌ 有偏(漏 Part 2) |
| k3 | ❌ 有偏 | ❌ 有偏 | ❌ 有偏 |
而 IR 没有这个问题——因为 IR 是把 KL 塞进 reward,然后走标准的 policy gradient / advantage 通道,reward-to-go 的累加是 PPO 框架天然就帮你做了的。Part 2 在 IR 里是自动包含的。
这是 IR 一个被严重低估的结构性优势:它不改变优化机制,只改变 reward 数值。 所有 policy gradient 的正确性结论(reward-to-go、advantage、baseline 降方差)原封不动继承。你想不出错都难。
六、Off-policy 这一层
前面五节的推导有一个隐藏前提:$y\sim\pi_\theta$,即数据是当前策略自己采出来的。但 PPO/GRPO 实际是 off-policy 的——数据由 $\pi_{\text{old}}$(行为策略,可能是上一轮的 $\pi_\theta$,也可能是切了 mini-batch 之后过时的版本)采出,更新的却是 $\pi_\theta$。标准 PPO 对 reward 项有 importance sampling 比值 $\rho_t=\pi_\theta/\pi_{\text{old}}$,但KL 项通常没有——这是一个几乎所有框架都存在的不一致,而且它比”没做 IS”看起来的样子更隐蔽。
6.1 统一记号:把 IS 权重也代进梯度里
为了把 on-policy 和 off-policy 放进同一个框架,定义
$$\rho(y) = \frac{\pi_\theta(y|x)}{\text{sg}(\pi_{\text{old}}(y|x))}$$
$\pi_{\text{old}}$ 不含 $\theta$,天然 stop-grad。关键的地方在于:on-policy($\pi_{\text{old}}=\pi_\theta$)时 $\rho\equiv1$ 这件事只是个数值上的巧合,不是梯度上的。
$$\nabla_\theta \rho(y) = \nabla_\theta\frac{\pi_\theta(y)}{\pi_{\text{old}}(y)} = \rho(y)\,\nabla_\theta\log\pi_\theta(y) = \rho(y)\,s_\theta(y)$$
代入 on-policy 极限 $\rho=1$,得到 $\nabla_\theta\rho = s_\theta(y) \neq 0$。$\rho$ 的值恒为 1,但它的梯度不是 0。 这和第二节”KL 梯度必须包含路径导数”是同一个陷阱的另一种形式——只是这次藏在一个看起来像常数的量里。任何直接对 $\rho\cdot k(y)$ 反传、却把 $\rho$ 当常数处理的实现,都会漏掉 $k(y)\cdot\nabla_\theta\rho = k(y)\,\rho\,s_\theta$ 这一项。
6.2 这正是 GRPO 原始 k3-loss 的 bug 根源
回头看 4.4:$\nabla_\theta[\text{k3-in-Loss}] = \nabla_\theta D_{\text{KL}}(\pi_{\text{ref}}\|\pi_\theta)$(正向 KL 梯度,方向错了)。现在可以把这个结果重新理解一遍:GRPO 原始论文的写法是直接对 $k_3(y;\theta)$ 反传,完全没有 $\rho$——因为大家觉得”反正是 on-policy,$\rho\equiv1$,乘不乘无所谓”。但根据 6.1,这个想法本身就是错的:即使 on-policy,完整的梯度也应该是 $\nabla_\theta[\rho\cdot k_3]$,而不是 $\rho\cdot\nabla_\theta k_3$。丢掉的正是 $k_3\cdot\nabla_\theta\rho = k_3\cdot s_\theta$ 这一项。
补上这一项会发生什么?用乘积法则展开 $\nabla_\theta[\rho k_3]$($s(y)=\pi_{\text{ref}}/\pi_\theta$,$\nabla_\theta k_3 = (1-s)s_\theta$,$\nabla_\theta\rho=\rho s_\theta$):
$$\nabla_\theta[\rho k_3] = k_3\cdot\rho s_\theta + \rho\cdot(1-s)s_\theta = \rho s_\theta\big[\underbrace{(s-1-\log s)}_{k_3} + 1 - s\big] = \rho s_\theta\cdot(-\log s) = \rho\, s_\theta\, k_1$$
漏掉的那一项和保留的那一项恰好凑成了 $k_1$。也就是说,完整的 $\rho k_3$ 恰好精确等于 $\rho\, s_\theta\, k_1$——这正是(把 $\rho$ 换成 IS 权重之后的)反向 KL 的得分函数梯度。我数值验证过这条恒等式,逐样本残差在浮点精度以内,不是期望意义上的近似。
同样的展开对 $\text{sg}(\rho)\cdot k_2$($\rho$ 当常数、只对 $k_2$ 反传)也成立:$\nabla_\theta k_2 = k_1 s_\theta$,所以 $\nabla_\theta[\text{sg}(\rho)k_2] = \rho\cdot k_1 s_\theta$——和完整的 $\rho k_3$ 逐样本完全相同,不只是期望相同,是同一个随机变量:
$$\boxed{\nabla_\theta\big[\text{sg}(\rho)\cdot k_2\big] \equiv \nabla_\theta\big[\rho\cdot k_3\big] = \rho(y)\,s_\theta(y)\,k_1(y)}$$
数值验证(6 类分布,$\pi_{\text{old}}$ 和 $\pi_\theta$ 显式不同):
E_old[rho*s*(k1+1)]      与真反向KL梯度误差 = 1.2e-10
E_old[sg(rho)*grad k2]   与真反向KL梯度误差 = 1.2e-10
E_old[rho*grad k3]       与真反向KL梯度误差 = 1.2e-10
sg(rho)*grad_k2 与 rho*grad_k3 的逐样本差   = 0.0  <- 精确恒等,不是期望相等
三个东西($\rho k_1$ 全量反传、$\text{sg}(\rho)k_2$、$\rho k_3$)都精确收敛到反向 KL 的真梯度,且后两者逐样本恒等。而去掉 $\rho$、直接反传裸 $k_3$(GRPO 原始写法),on-policy 极限下精确等于正向 KL 梯度(4.4 已证),off-policy 时则既不是正向也不是反向 KL 的梯度,就是一个 generic 的错误量——数值上离两者都更远。
这也解释了 DeepSeek-V3.2 的修复为什么有效:它给 KL 估计器显式乘上 $\rho_t=\pi_\theta/\pi_{\text{old}}$,本质上就是把裸 $k_3$ 换成 $\rho k_3$——而这恰好是上面证明的、能精确复原反向 KL 梯度的形式。这不是”给 off-policy 加了个修正”那么简单,它同时也修好了 on-policy 场景下 GRPO 原始写法里那个被忽略的 $\nabla_\theta\rho$ 项。
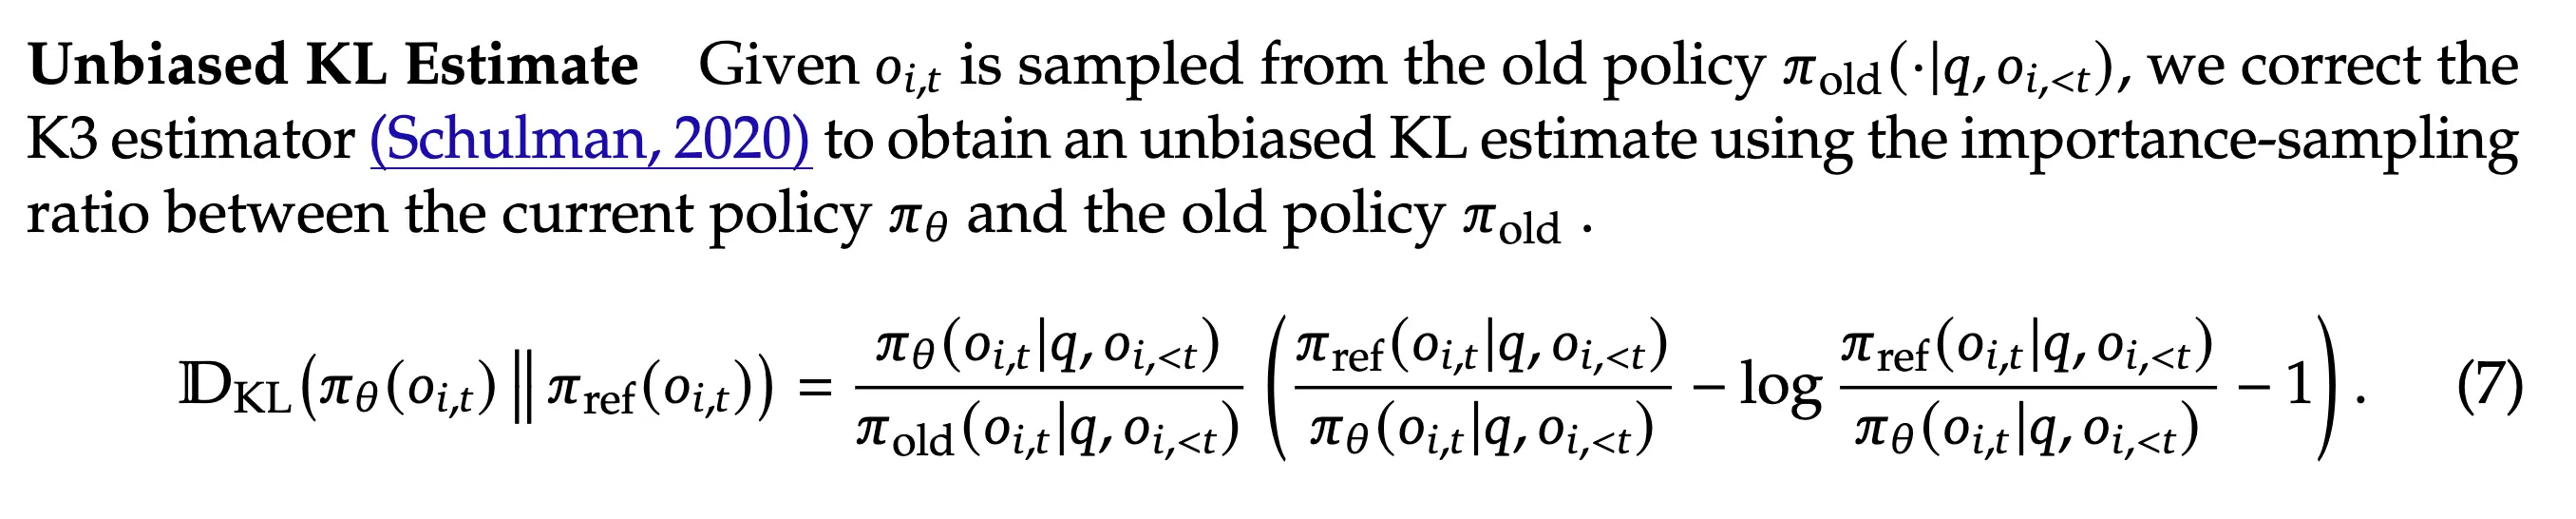
if args.use_kl_loss:

ref_log_probs = batch["ref_log_probs"]

ref_log_probs = torch.cat(ref_log_probs, dim=0)

importance_ratio = None

if args.use_unbiased_kl:

importance_ratio = torch.exp(log_probs - old_log_probs)

kl = compute_approx_kl(

log_probs,

ref_log_probs,

kl_loss_type=args.kl_loss_type,

importance_ratio=importance_ratio,

)

kl_loss = sum_of_sample_mean(kl)


loss = loss + args.kl_loss_coef * kl_loss
当然,第五节的坑还在:只要 token-level 展开仍然只算 Part 1,补了 $\rho$ 也换不回完整无偏——修了一个洞,另一个洞还在。
6.3 和 4.3 的呼应:一个更大的恒等式家族
上面这套 $\rho$ 记号还揭示了一件事:4.3 节的 $\text{k2-in-Loss}\equiv\text{k1-in-Reward}$,其实是这个 off-policy 恒等式在 $\rho\equiv1$ 时的特例。 把 $\rho=1$(on-policy)代入 $\text{sg}(\rho)k_2\equiv\rho k_3$,得到 $k_2$-loss $\equiv$ $k_3$-with-$\rho$-loss $= s_\theta k_1$——这正是 4.3 算出的 $\text{k1-in-Reward}$ 的梯度。也就是说,”$k_1$ 的得分函数梯度 $s_\theta k_1$”这个表达式,是三种写法(k1-IR、k2-IL、$\rho$k3-IL/sg($\rho$)k2-IL)共同的落脚点,区别只是从哪条路径到达它。
反过来,这也告诉我们 loss 和 reward 两种放法,在样本级别可以给出完全相同的梯度随机变量,但整体更新语义仍有区别:
- 是否经过 advantage / baseline:reward 里的 KL 项会被 GRPO/PPO 的 baseline 处理、可能被部分吸收进 advantage 的中心化里;loss 里的 KL 项是独立加的正则梯度,不受 baseline 影响。
- 信用分配路径:loss 是逐 token 局部生效;reward 会随 return 沿时间线往前传播(这正是第五节 Part 2 的来源——reward-to-go 自动把后续的 KL 惨罚记到前面的 token 头上,loss 写法默认没有)。
所以”梯度随机变量相同”不等于”训练效果相同”——这也是为什么本文一直强调要连着”放置位置”和”token 展开”一起看,单独讨论”哪个估计器无偏”永远是半个问题。
6.4 Reward Shaping 下的 Off-policy:结论不变,但要小心批内归一化
第四节证明的”只有 k1-IR 精确无偏”这个结论,off-policy 下要不要重新证一遍?其实不用。标准 PPO 的做法是把 IS 比值 $\rho_{\text{pg}}=\pi_\theta/\pi_{\text{old}}$ 乘在整条得分函数项上(reward 和折进 reward 里的 KL 一起乘),这个比值和”KL 估计器本身选哪个”“路径导数期望是否为零”是两件独立的事——k1 的路径导数恒为 0 这个论证全程没用到 on-policy 假设,off-policy 下继续成立。所以结论照搬:reward shaping 下 off-policy 也只有 k1 精确无偏,k2/k3 折进 reward 一样会带进那个符号相反的正向 KL 污染项。
唯一需要额外小心的是一个和 KL 估计器本身无关、但经常和它绑在一起出现的坑:GRPO 式的组内(group-relative)reward 归一化。如果对 shaped reward $r'=r-\beta k$ 做”减去批内均值再除以批内标准差”,且均值/方差的计算包含了当前这条样本自己,会引入 $O(1/n)$ 的系统性偏差(自己被自己的统计量除了一次)。这个偏差和 KL 估计器无偏与否叠加在一起,会让”我明明用了 k1-IR”却依然对不上手推结论。修法很直接:用 leave-one-out 的均值/方差(算统计量时去掉当前样本),既能保持严格无偏,又不损失方差缩减的效果。这条和 KL 本身的偏差无关,但因为归一化和 KL 项通常写在同一段代码里,经常被一起冤枉。
七、真正能落地的 Takeaway
前面全是推导,这一节讲怎么用。先给一张速查表,后面再展开讲每一行的理由。
7.1 速查表
| 场景 | 推荐写法 | 一句话理由 | 出处 |
|---|---|---|---|
| On-policy,KL in Reward | k1 | 路径导数期望恒为 0,精确无偏,且对 stop-grad 免疫 | §4.1 |
| On-policy,KL in Loss | k2;或显式写出 $\rho k_3$ / $\text{sg}(\rho)k_2$ | k2-loss 精确等价于 k1-in-Reward;裸 k3-loss(不带 $\rho$)会退化成正向 KL 梯度,方向错了,不是大小错了 | §4.3、§4.4、§6.2 |
| Off-policy,KL in Reward | k1,套标准 PPO 整条 IS 比值即可,KL 项不用再单独加权 | k1 路径导数为零这个论证不依赖 on-policy 假设 | §6.4 |
| Off-policy,KL in Loss | $\rho k_3$ 或 $\text{sg}(\rho)k_2$(逐样本恒等,选哪个纯看实现方便) | 唯二能在 off-policy 下精确复原反向 KL 真梯度的写法;裸 $\rho k_1$ 虽也无偏但方差大得多 | §6.1、§6.2 |
| 监控 / 画曲线 / early stop 判据 | k3(或算力够就上 full-vocab 精确 KL) | 无偏 + 非负 + 低方差三者都要;和梯度走哪条路径完全独立 | §7.4 |
表里没写但必须记住的两条横切规则:token-level 实现要有 Part 2(§5,否则 loss 一列全部退化);离 $\pi_{\text{ref}}$ 越远,表里所有”近似成立”的结论越不成立(§7.5)。
7.2 默认选择
默认用 k1-in-Reward。
理由不是它数学上最优雅,而是它在工程上最难写错:
- 梯度精确无偏,不是近似;
- 对 stop-grad 免疫(4.1 的推论)——log 项包不包
no_grad都一样,少一个出错点; - token-level 的 Part 2 由 PPO 的 reward-to-go 自动包含,不需要你手写;
- 不改变优化机制,advantage / baseline / value function 全部原样复用。
k1 唯一的缺点是值的方差大,但注意——这个缺点在 IR 里被大幅稀释了:KL 是加进 reward 再过 advantage 和 baseline 的,PPO 的方差缩减机制本来就在处理这个。你不是拿单样本 k1 直接当梯度用。
7.3 如果你的框架只能 KL-in-Loss
很多框架(GRPO 系)就是 in-loss 的,改不动。这里要分 on-policy 和 off-policy 两种情况——它们的正确答案不一样。
On-policy($\pi_{\text{old}}=\pi_\theta$,或者干脆没有 $\pi_{\text{old}}$ 这个概念):
- 绝对不要用 k1。它梯度期望为 0,等于没加正则还平白增加方差。这是最容易犯且最隐蔽的错。
- 理论最优是 k2,它 sequence-level 精确等价于 k1-IR。
- 如果直接用裸 k3 反传,要知道你在正则正向 KL,不是反向 KL(§4.4、§6.2)——除非你显式把 $\rho$(哪怕 on-policy 下 $\rho\equiv1$,见 §6.1)乘进去再反传,那样才会精确落回反向 KL 的梯度。
- 如果能改实现,把 Part 2 补上——具体做法是让 token $t$ 的 KL 系数变成从 $t$ 到 $T$ 的 KL 累加(reward-to-go 形式),而不是只用 token $t$ 自己的 KL。这是把 IL 修对的唯一办法。
Off-policy(mini-batch 复用、$\pi_{\text{old}}\neq\pi_\theta$):
- 用 $\rho k_3$ 或 $\text{sg}(\rho)k_2$(§6.2 已证逐样本恒等),两者都能精确复原反向 KL 的真梯度。裸 k3(不带 $\rho$)此时既不是反向也不是正向 KL 的梯度,纯粹是个 generic 的错误量,比 on-policy 下的”至少还是个正确的正向 KL 梯度”更糟。
- DeepSeek-V3.2 的修复本质上就是把 GRPO 的裸 $k_3$-loss 换成 $\rho k_3$——这一步同时修好了”off-policy 没做 IS”和”on-policy 也漏掉 $\nabla_\theta\rho$”两个问题,虽然论文的表述强调的是前者。
顺带回答一个自然的疑问:既然 k2 理论上最优,为什么框架默认给的都是 k3? 除了路径依赖(DeepSeekMath 的 GRPO 公式里写的就是 k3,后面全抄)之外,有两个不那么显然的实质理由:
- 非负性在 loss 里是硬需求。 $k_3\ge0$ 意味着优化器不可能靠”把 KL 项推成负数”来刷低 loss。k1 在 loss 里可以无限往负漂(尽管期望为 0),这在有限 batch 上是真实的失效模式。k2 虽然也非负,但它是平方项,对 outlier token($\log s$ 很大的那些)的梯度响应比 k3 的线性响应更剧烈。
- 无偏从来不是 RL 里的最高优先级。 无偏只是对无穷样本的承诺,有限 batch 下决定优化质量的是 MSE = 偏差² + 方差。k1 的方差是信号的几十上百倍,k3 只有 1.6 倍。用一点偏差换两个数量级的方差,几乎总是划算的。(
verl的 k3+ 实现——前向算 k3 的非负值当监控,反向换成 k2 的梯度——就是把”数值要 k3、梯度要 k2”这个诉求直接写进了框架里,参见 §4 六宫格下面的说明。)
7.4 值和梯度要分开选
这是我认为最有实操价值的一条,也是很多人没意识到的:
监控用的 KL 和参与梯度的 KL,不必是同一个估计器。
- 打日志、画曲线、做 early stop 判据 → 用 k3(无偏 + 非负 + 低方差,三个都要)。别用 k1,它单样本方差是信号的几十上百倍,你画出来的是噪声。
- 参与反向传播 → 按 7.1 速查表 / 7.2 / 7.3 选。
这两件事在代码里就应该是两个独立的量。把它们混为一谈,是 k3 被误用到 reward 里的根本原因——大家看 k3 值算得准,就以为放哪儿梯度都准。
另外,如果显存和算力允许,监控可以直接算 full-vocab 的逐 token 精确 KL(对词表求和而不是单样本),它对序列 KL 无偏且方差极低。但注意:这只解决值的方差问题,不解决梯度缺项问题——它进 loss 时同样缺得分函数项 / Part 2。
7.5 什么时候偏差可以忽略,什么时候必须小心
可以忽略的场景:
- $\beta$ 很小,KL 只是个弱兜底(现在很多 reasoning RL 干脆 $\beta=0$)。这时候你争论哪个估计器无偏没有意义。
- 训练全程 KL 稳定在很小的量级(比如 <0.01),且没有出现漂移趋势。此时 k2/k3 之间、IR/IL 之间的差别都是高阶小量。
- 短序列。Part 2 的缺失量随序列长度增长,短序列上影响有限。
必须小心的场景:
- 长 CoT / 长序列生成。 Part 2 漏掉的是 $T-t$ 项的累加,$T$ 越大漏得越多。这是当前 reasoning RL 最相关的场景。
- $\beta$ 较大、真的指望 KL 拴住模型。 这时 k3-IR 那个”一阶抵消”会直接坑你:你以为拴住了,其实绳子是软的。
- KL 已经涨起来了(>0.1 量级)。 所有”$s\approx 1$ 的近似”全部失效:k2 值偏 17%,而 k3-IL 那个”正反向 KL 等价”的理由也不再成立——此时你是在实打实地正则一个和你以为的不同的散度(相对误差可达 30%)。注意这是个恶性循环:KL 一涨,估计器就变差,正则就更弱,KL 涨得更快。
- off-policy 程度高(一批数据复用多个 epoch、mini-batch 切得细、$\pi_\theta$ 和 $\pi_{\text{old}}$ 拉开)。裸估计器(不带 $\rho$)此时既不是反向也不是正向 KL 的梯度,比 on-policy 下的”至少还是个合法散度”更糟(§6.2)。
- 换框架 / 换 KL 实现之后调不出原来的效果。 大概率不是超参问题,是你从六宫格的一格换到了另一格,有效正则强度整个变了。$\beta$ 在不同格子之间不可迁移。
7.6 一条自检清单
改动任何 KL 相关代码后,问自己五个问题:
- 我用的是哪个估计器?
- 它是进 reward 还是进 loss?(等价于问:stop-grad 打在采样分布上还是 log 项上?)
- 如果进 loss,token-level 展开有没有 Part 2?
- 数据是不是 off-policy?如果是,重要性权重 $\rho$ 有没有乘进 KL 项——而且是不 stop-grad 地乘进去(§6.1,$\rho\equiv1$ 时它的梯度也不是 0)?
- 如果这条数据是当作 reward 用的,批内归一化(如果有)算没算进当前样本自己(§6.4,留一法 vs 直接算)?
五个答案凑齐了,才能说清楚自己的 KL 正则到底是什么。只回答第 1 个问题——”我用的是 k3,无偏的”——是没有意义的。
八、一句话总结
如果只能记一句:
“这个估计器是不是无偏的”是个病态问题。正确的问法是”这个估计器 × 这种放法 × 这种 token 展开,梯度是不是无偏的”。而在这三个维度上都最稳的答案,是 k1-in-Reward。
有点反讽的是:最朴素、方差最大、看起来最不该用的 k1,配上最老的 InstructGPT 式放法,反而是唯一一个从头到尾都严格正确的组合。 k2/k3 那些精巧的方差缩减设计,优化的是”值”这个我们其实不太在乎的量——而它们对”梯度”这个我们真正在乎的量的影响,完全取决于被放在哪一格。
不过要给 k3 说句公道话,这也是我写完这篇才想清楚的:k3 的流行不是因为大家没注意到它不是真梯度,而是因为它被用在了 IL 这个”错得最无害”的位置上。 在那里它等价于精确的正向 KL 正则——一个合法的、只是方向和设计初心(反向 KL)不同的散度,配上非负性和低方差,在 $\pi_\theta\approx\pi_{\text{ref}}$ 的工作区间内是个相当合理的工程选择;而 off-policy 时(第六节)它连”精确的另一个散度”都不是,必须补上重要性权重 $\rho$ 才能救回来。
真正该警惕的是另外两格:k3/k2-in-Reward(正反向 KL 一阶抵消,正则形同虚设)和 k1-in-Loss(梯度恒为 0)。这两格才是会让你”以为加了 KL 其实没加”的陷阱——而且它们不报错、曲线看着还挺正常。
繁华落尽见真淳。
附录 A:对数技巧
全文反复用到:
$$\nabla_\theta \pi_\theta(y|x) = \pi_\theta(y|x)\,\nabla_\theta\log\pi_\theta(y|x)$$
由 $\nabla_\theta\log\pi_\theta = \frac{1}{\pi_\theta}\nabla_\theta\pi_\theta$ 两边乘 $\pi_\theta$ 移项即得。
它的两个直接推论撑起了整篇文章:
- $\mathbb{E}_{y\sim\pi_\theta}[\nabla_\theta\log\pi_\theta(y)] = 0$ → k1 路径导数消失
- $\mathbb{E}_{y\sim\pi_\theta}[s(y)] = 1$ → k3 的控制变量项无偏
附录 B:数值验证
用一个 $K$ 类离散分布(softmax 参数化)暴力验证六宫格的每一格,以及 k3-IR 的正向 KL 恒等式:
import numpy as np
K = 6
softmax = lambda z: (lambda e: e/e.sum())(np.exp(z - z.max()))

zr = np.random.randn(K); zt = zr + 0.3*np.random.randn(K)
p, q = softmax(zt), softmax(zr)
G = np.eye(K) - p[None, :]            # G[y] = grad_z log p(y)
s = q/p
k1, k2, k3 = -np.log(s), 0.5*np.log(s)**2, -np.log(s) + (s-1)

score = lambda c: (p[:, None] * c[:, None] * G).sum(0)   # IR: E[c * grad log p]
IR = {'k1': score(k1), 'k2': score(k2), 'k3': score(k3)}
IL = {'k1': (p[:, None] * G).sum(0),                      # grad k1 = grad log p
      'k2': (p[:, None] * k1[:, None] * G).sum(0),        # grad k2 = k1 * grad log p
      'k3': (p[:, None] * (1-s)[:, None] * G).sum(0)}     # grad k3 = (1-s) * grad log p
把上面的结果和有限差分算出的真梯度 $\nabla_z D_{\text{KL}}(p\|q)$ 对比,得到:
--- 距离大    KL=0.07915  |真梯度|=1.763e-01
   k1_IR   |g|=1.763e-01   误差=8.8e-11   <- 精确
   k2_IR   |g|=3.461e-02   误差=1.6e-01
   k3_IR   |g|=3.042e-02   误差=1.6e-01
   k1_IL   |g|=3.4e-17     误差=1.8e-01   <- 恒为 0
   k2_IL   |g|=1.763e-01   误差=8.8e-11   <- 精确
   k3_IL   |g|=1.646e-01   误差=3.0e-02
   校验 k3_IR == 真梯度 - 正向KL梯度 ? 残差 2.0e-10   <- 恒等式成立

--- 距离很小  KL=0.00122  |真梯度|=3.025e-02
   k1_IR   |g|=3.025e-02   误差=1.2e-10
   k3_IR   |g|=2.251e-04   <- 只有真梯度的 0.74%,正则几乎消失
再单独验证 k3-IL 的身份(4.4 的第一个 boxed 式):
=== k3_IL vs 正向 KL 梯度 ===
eps=1.00 : |k3_IL - grad KL(ref||th)| = 1.8e-10    k3_IL 相对真梯度误差 = 31.21%
eps=0.30 : |k3_IL - grad KL(ref||th)| = 1.5e-10    k3_IL 相对真梯度误差 = 16.20%
eps=0.10 : |k3_IL - grad KL(ref||th)| = 8.2e-11    k3_IL 相对真梯度误差 =  5.36%
eps=0.03 : |k3_IL - grad KL(ref||th)| = 1.2e-10    k3_IL 相对真梯度误差 =  0.63%
左列的残差在任何距离下都是浮点噪声——k3-IL 恒等于正向 KL 梯度,不是近似。右列则显示它和反向 KL 真梯度的差距随距离缩小而消失。
三个结论被精确验证:
- k1_IR 和 k2_IL 的误差在 $10^{-10}$ 量级(浮点噪声),是恒等而非近似;
- k3_IL $\equiv \nabla D_{\text{KL}}(\pi_{\text{ref}}\|\pi_\theta)$(正向 KL 梯度),残差 $10^{-10}$,而它相对反向 KL 真梯度的误差 → 0.63%;
- k3_IR 的梯度模长随 $\pi_\theta\to\pi_{\text{ref}}$ 迅速塌陷到真梯度的 1% 以下——第 4.4 节”一阶抵消”的直接证据。
第 2 条和第 3 条并列看,就是 4.4 末尾那张表想说的事:同一个 k3,IL 位置上”只差 0.6%”,IR 位置上”只剩 0.7%”。
参考
- On a few pitfalls in KL divergence gradient estimation for RL. arxiv 2506.09477 —— 最早给出正确梯度形式并系统分析业界做法的工作,主要面向 in-loss。
- Rethinking KL Regularization in RLHF: From Value Estimation to Gradient Optimization. arxiv 2510.01555 —— 细节充分,但缺 token-level 分析。本文”标红 $\theta$”的记法来自这里。
- A Comedy of Estimators: On KL Regularization in RL Training of LLMs. arxiv 2512.21852 —— Bengio 组,ICLR’26 被拒。
- John Schulman, Approximating KL Divergence —— k3 的出处。
- 繁华落尽见真淳:LLM 强化学习中 KL 散度的正确形式是 k1 in Reward —— 六宫格、Part 2、”值 vs 梯度”这条主线的分析来自这篇。
- RL 中的 KL 估计器选型:从数值无偏到梯度正确 —— 第六节的 $\rho$ 记号、on/off-policy 统一梯度框架、$\text{sg}(\rho)k_2\equiv\rho k_3$ 恒等式、reward shaping 下的批内归一化陷阱,都来自这篇。本文”反向/正向 KL”的命名约定也是照这篇(以及标准变分推断惯例)统一过来的。